
Todo tutorial de “Next.js + NestJS” para no npm run dev funcionando local. O problema real começa depois: como esses dois processos viram um SaaS que aguenta usuário pagante, múltiplos tenants, deploy sem downtime e um pico de tráfego que não avisa antes de chegar.
Esse post é o desenho completo — as camadas, os cuidados técnicos que ninguém lista no tutorial básico, e os recursos que decidem se o sistema escala ou cai no primeiro susto. O fio condutor é um caso real: a arquitetura que uso pra hospedar os produtos do Nico Platform, um conjunto de SaaS auto-hospedados numa VPS própria, cada um com Next.js no front e NestJS como BFF.
O que muda quando vira SaaS de verdade
Rodar Next.js e NestJS juntos é fácil. O que é difícil — e é isso que separa um projeto de portfólio de um SaaS — é uma lista de perguntas que só aparece sob carga real:
O NestJS guarda algum estado em memória (sessão, cache local, contador) que quebra assim que você sobe uma segunda instância dele? Uma migration de banco trava a tabela por tempo suficiente pra derrubar requisição em produção? Upload de arquivo grande segura uma conexão HTTP do container principal enquanto processa? Um deploy novo mata requisição em andamento, ou espera ela terminar?
Nenhuma dessas perguntas aparece com um usuário só, numa máquina só, em ambiente de desenvolvimento. Todas aparecem no primeiro mês com usuário pagante.
As camadas e o que cada uma resolve
Next.js é a camada de apresentação. Renderiza SSR pra primeira carga (importa pra SEO em página pública e pra tempo de primeira exibição) e client-side pra navegação dentro do app já autenticado. Ele não guarda regra de negócio — só sabe montar tela e chamar o BFF.
NestJS como BFF é a camada que existe pra o frontend não precisar conhecer a topologia do backend. Ele agrega múltiplas chamadas internas numa resposta só, adapta formato, e é o único ponto que fala com autenticação, banco e serviços de domínio:
// bff/dashboard/dashboard.controller.ts
@UseGuards(JwtAuthGuard)
@Get('dashboard')
async getDashboard(@CurrentUser() user: AuthUser) {
  const [perfil, resumo, notificacoes] = await Promise.all([
    this.perfilService.buscar(user.id),
    this.resumoService.calcular(user.id),
    this.notificacaoService.listarNaoLidas(user.id),
  ]);

  return { perfil, resumo, notificacoes };
}
Em produto pequeno, o próprio NestJS acumula regra de negócio junto com o papel de BFF — não tem problema nisso enquanto o time é pequeno. Serviços de domínio separados só valem a pena quando um pedaço específico precisa escalar, fazer deploy ou usar linguagem diferente do resto (processamento pesado, integração externa lenta, fila dedicada).
Postgres guarda o dado transacional — usuário, assinatura, dado de negócio. Redis cobre três papéis diferentes que vale a pena distinguir: cache de leitura repetida, fila de job assíncrono (via BullMQ), e — se a sessão não for só JWT — armazenamento de sessão compartilhado entre instâncias.
Object storage compatível com S3 (S3 mesmo, ou uma alternativa self-hosted como o Garage) guarda o binário — upload de usuário, anexo, imagem de perfil. Nunca o Postgres, que não foi feito pra isso e cresce rápido demais quando vira depósito de arquivo.
Cuidados técnicos que decidem se aguenta produção
Cinco pontos que, ignorados, funcionam perfeitamente em desenvolvimento e falham exatamente quando o SaaS ganha o primeiro cliente de verdade.
Autenticação sem estado no servidor. JWT assinado, validado em cada instância do NestJS sem consultar sessão em memória, é o que permite subir e derrubar container livremente. Se o produto precisa de logout imediato ou revogação de token, isso vai pro Redis (uma denylist com TTL igual à expiração do token) — nunca pra memória do processo.
Upload não passa pelo processo da aplicação. O padrão que evita segurar uma conexão de minutos enquanto 50MB sobem: o frontend pede uma presigned URL ao BFF, e o navegador envia o arquivo direto pro storage. O NestJS só grava a referência depois que o upload confirma:
// bff/upload/upload.controller.ts
@Post('upload-url')
async gerarUrlUpload(@Body() dto: { nomeArquivo: string; tipo: string }) {
  const key = `uploads/${randomUUID()}-${dto.nomeArquivo}`;
  const url = await this.storageService.presignedPutUrl(key, dto.tipo, 300); // expira em 5min
  return { url, key };
}
Migration de banco não é atômica com o deploy. Rodar prisma migrate deploy (ou equivalente) antes de trocar a versão do container evita o cenário em que código novo espera uma coluna que a migration ainda não aplicou. Migration que adiciona coluna NOT NULL sem default trava a tabela inteira durante a execução — em tabela grande, isso é minutos de indisponibilidade. Adicionar como opcional, popular, só depois tornar obrigatória, evita o lock.
Graceful shutdown. Quando o orquestrador manda SIGTERM pra trocar de versão, o processo precisa parar de aceitar requisição nova mas terminar a que já está em andamento, antes de morrer:
// main.ts
app.enableShutdownHooks();

process.on('SIGTERM', async () => {
  await app.close(); // termina requisições em voo, fecha conexões de banco
  process.exit(0);
});
Sem isso, todo deploy derruba requisição no ar — silenciosamente, sem aparecer em log de erro do jeito óbvio.
Configuração por ambiente, nunca hardcoded. Toda credencial (string de conexão, chave de assinatura JWT, chave da API de storage) vem de variável de ambiente, validada no boot — não descoberta em runtime quando falha:
// config/env.validation.ts
const envSchema = z.object({
  DATABASE_URL: z.string().url(),
  JWT_SECRET: z.string().min(32),
  REDIS_URL: z.string().url(),
});

export const env = envSchema.parse(process.env); // quebra o boot, não a primeira requisiçãoDesenhando a arquitetura
Com as camadas e os cuidados definidos, esse é o desenho de produção — Cloudflare na frente absorvendo DDoS e cacheando ativo estático, Traefik roteando por domínio com HTTPS automático, containers de Next.js e NestJS replicados, e a base de dado, cache/fila e storage compartilhados entre eles:
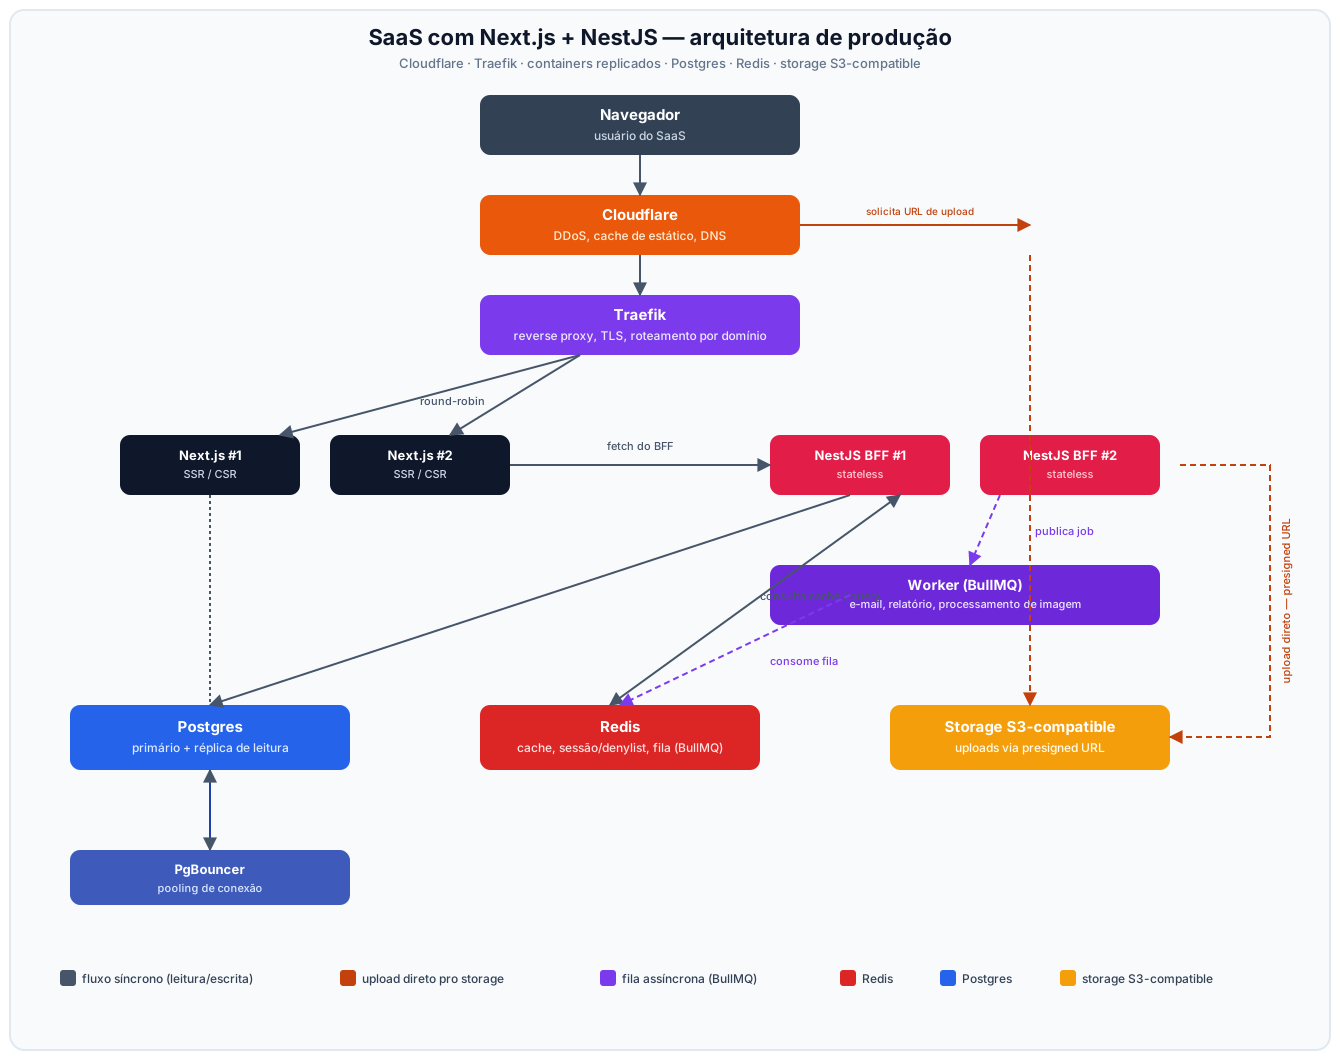
Fluxo síncrono (cinza): o navegador bate no Cloudflare, que já responde direto pra ativo estático cacheado e passa o resto pro Traefik. O Traefik termina TLS e distribui entre as réplicas de Next.js (SSR) por round-robin — qualquer réplica serve qualquer requisição, porque nenhuma guarda estado local. O Next.js chama o BFF NestJS, também replicado atrás do mesmo Traefik, que consulta Redis antes do Postgres pra dado cacheável e vai direto ao Postgres pro resto.
Upload (laranja): sai do fluxo principal desde o pedido de presigned URL — o arquivo em si nunca passa pelos containers de aplicação, vai direto do navegador pro storage.
Fila assíncrona (roxo): o BFF publica job no Redis (enviar e-mail, gerar relatório, processar imagem) e devolve resposta imediata pro usuário. Um worker separado — mesmo código do NestJS, processo diferente — consome a fila em paralelo, sem competir por CPU com quem está respondendo requisição HTTP.
Nenhuma seta desse diagrama depende de container específico ter memória do que aconteceu antes. É essa propriedade — não o número de réplicas — que faz a arquitetura escalar.
Recursos que realmente escalam
Na ordem em que cada um resolve um gargalo diferente, do mais barato ao mais trabalhoso.
Cache em camadas. Cloudflare cacheia ativo estático e resposta pública com TTL; Redis cacheia resultado de query cara e específica por usuário, sempre com TTL — cache sem expiração é fonte de dado desatualizado disfarçada de otimização.
Connection pooling no Postgres. Cada réplica de NestJS abrindo seu próprio pool de conexão esgota o limite do Postgres rápido — um Postgres padrão aguenta ~100 conexões simultâneas, e três réplicas com pool de 20 já usam 60 só de idle. Um pooler externo (PgBouncer, ou o pooler embutido de provedores como Neon/Supabase) resolve isso multiplexando conexão real por trás de um número bem maior de conexões lógicas.
Filas pra tudo que não precisa de resposta síncrona. E-mail, geração de relatório, processamento de imagem, notificação — qualquer coisa que o usuário não precisa esperar terminar na mesma requisição vai pra fila (BullMQ sobre Redis é a escolha natural já tendo Redis no stack):
// worker/email.processor.ts
@Processor('emails')
export class EmailProcessor {
  @Process('boas-vindas')
  async enviarBoasVindas(job: Job<{ userId: string }>) {
    const usuario = await this.usuarioService.buscar(job.data.userId);
    await this.mailer.enviar(usuario.email, 'boas-vindas', { nome: usuario.nome });
  }
}
Réplica de leitura no Postgres, quando o volume de leitura supera muito a escrita — dashboard, relatório, listagem — sem competir com a escrita transacional pelo mesmo banco primário.
Escalar horizontalmente antes de verticalmente. Trocar uma VPS por uma maior tem teto — em algum ponto você paga o dobro por 30% a mais de capacidade. Rodar três réplicas menores do NestJS atrás do Traefik custa parecido e dá redundância de graça: uma réplica cai, as outras duas seguem respondendo.
# docker-compose.yml — réplicas do BFF atrás do mesmo Traefik
services:
  bff:
    build: ./apps/bff
    deploy:
      replicas: 3
    networks:
      - proxy
    labels:
      - "traefik.enable=true"
      - "traefik.http.routers.bff.rule=Host(`api.meusaas.com`)"
      - "traefik.http.services.bff.loadbalancer.server.port=3000"
      - "traefik.http.services.bff.loadbalancer.healthcheck.path=/health"
O healthcheck.path importa tanto quanto o número de réplicas: sem ele, o Traefik continua mandando tráfego pra uma réplica travada até ela responder erro — com ele, uma réplica que falha o health check sai da rotação sozinha.
Caso de uso: aplicando no Nico Platform
O Nico Platform é o exemplo real por trás desse desenho — um monorepo (Turborepo) com múltiplos produtos independentes (FitFlow, Ledge, ConectaCondominio, RiffBook), cada um com seu próprio Next.js e seu próprio BFF em NestJS, todos rodando na mesma VPS na Hostinger.
Um produto, um par de containers
FitFlow sobe com Next.js e NestJS num container cada, atrás do Traefik, Postgres compartilhado na mesma VPS em /opt/docker/postgres. Suficiente pra validar produto com usuário real.
Infra compartilhada entre produtos
Redis, storage compatível com S3 (Garage, substituindo o antigo MinIO Community Edition) e Postgres centralizado passam a atender todos os produtos do monorepo — cada um com seu schema ou banco lógico, mas a mesma infra física, evitando reimplantar Postgres a cada produto novo.
Auth centralizado, sem SSO completo
Um auth-service cuida só de verificação de e-mail entre produtos (SSO completo foi descartado porque cada produto tem base de usuário separada), com Cloudflare Turnstile no fluxo de login e OTP guardado no Redis com TTL curto.
Escala por produto, não por plataforma
Quando um produto específico ganha tração, ele ganha réplica própria do BFF e, se necessário, worker dedicado — sem afetar os outros produtos do monorepo, porque cada BFF já era stateless desde a Fase 1.
Onde a maioria erra
Guardar sessão em memória do processo NestJS e descobrir o problema só quando sobe a segunda réplica. Rodar migration destrutiva junto com o deploy da aplicação, sem separar os dois passos. Deixar upload grande passar pelo mesmo processo que responde requisição HTTP normal, competindo por handle de conexão com todo o resto do tráfego. E confundir “mais CPU na VPS” com solução de escala, quando o gargalo real quase sempre é conexão de banco não reaproveitada ou cache que não existe.
Nenhuma arquitetura sobrevive intacta ao primeiro ano de produto real — o valor de desenhar isso com cuidado não é acertar de primeira, é deixar claro por que cada peça está onde está, pra saber exatamente o que mexer quando o gargalo aparecer.