
Já escrevi sobre onde S3 e CloudFront se encaixam ao lado de Lambda e API Gateway numa arquitetura. Este post fica só nos dois, com profundidade: o que cada um resolve, como configurar com segurança, e os detalhes que decidem custo e comportamento — os que só aparecem quando o projeto já está no ar.
S3: armazenamento de objeto, não sistema de arquivos
S3 (Simple Storage Service) guarda objetos — um arquivo mais metadado — dentro de buckets. Não existe pasta de verdade: o que parece uma estrutura de diretório (fotos/perfil/123.jpg) é só um nome de objeto (key) com barra, que ferramentas exibem como se fosse pasta. Essa diferença importa na hora de listar milhões de objetos ou de decidir uma convenção de nomenclatura.
A AWS anuncia durabilidade de 11 noves (99,999999999%) por ano pro Standard: o objeto está espalhado em múltiplas zonas de disponibilidade dentro da região. Isso é durabilidade de dado, não disponibilidade do serviço — os dois números são diferentes e valem checar na documentação da classe que você escolher.
Classes de armazenamento
Cada classe troca custo de armazenamento por custo de acesso ou por tempo de recuperação:
| Classe | Quando usar |
|---|---|
| S3 Standard | Acesso frequente, sem padrão previsível |
| S3 Intelligent-Tiering | Padrão de acesso desconhecido ou mudando; move o objeto entre camadas sozinho |
| S3 Standard-IA | Acesso raro, mas precisa estar disponível na hora quando pedido |
| S3 One Zone-IA | Acesso raro, e perder o dado numa falha de zona é aceitável (ex.: derivado, recriável) |
| S3 Glacier Instant Retrieval | Arquivo, mas com necessidade de acesso imediato |
| S3 Glacier Flexible Retrieval | Arquivo, com recuperação em minutos a horas |
| S3 Glacier Deep Archive | Retenção de longuíssimo prazo, recuperação em horas |
Pra escolher sem adivinhar, Lifecycle rules movem o objeto entre classes automaticamente por idade — por exemplo, log de aplicação vai pra Standard-IA depois de 30 dias e pra Glacier depois de 180, sem processo manual. É a peça que evita pagar preço de acesso frequente por dado que ninguém mais lê.
Segurança: bloqueado por padrão, liberado com intenção
Block Public Access vem ligado por padrão em bucket novo, e deveria continuar ligado na esmagadora maioria dos casos. Acesso é concedido por bucket policy (JSON anexado ao bucket, definindo quem pode fazer o quê) ou por política IAM anexada ao usuário/role. ACL de objeto é o mecanismo mais antigo dos três e a AWS recomenda evitá-lo em bucket novo, preferindo bucket policy e IAM.
O erro mais comum é liberar amplo demais — uma policy com "Action": "s3:*" quando o caso de uso pedia só s3:GetObject. Escreva a policy pro verbo que você realmente precisa.
Como o navegador sobe arquivo sem passar pelo backend
Fazer o backend receber o arquivo, gravar em disco e depois repassar pro S3 é dois saltos e dois pontos de falha. A alternativa é a presigned URL: o backend, autenticado com suas próprias credenciais, assina uma URL temporária que autoriza uma ação específica (PUT num key específico) por um tempo limitado. O navegador usa essa URL pra subir o arquivo direto pro bucket, e o backend só grava a referência no banco depois que o upload confirma.
Duas coisas pra funcionar de verdade:
- CORS no bucket. Sem uma configuração de CORS liberando o método e a origem do seu frontend, o navegador bloqueia a resposta antes mesmo dela chegar ao seu código.
- Escopo da presigned URL. Ela vale pra uma ação e um key específicos, dentro do tempo definido — não é uma chave de acesso geral ao bucket.
CloudFront: a camada que fica entre o usuário e a origem
CloudFront é a CDN (rede de distribuição de conteúdo) da AWS. Ele não guarda dado por conta própria: fica na frente de uma origem (um bucket S3, um load balancer, qualquer endpoint HTTP) e replica a resposta pelas edge locations espalhadas pelo mundo, entregando a partir do ponto mais próximo do usuário.
Uma distribution é a configuração do CloudFront: qual origem, qual domínio, qual certificado. Dentro dela, cache behaviors decidem regra por padrão de caminho — /images/* pode ter TTL de um dia, /api/* pode não cachear nada. Cache policies (o mecanismo atual, no lugar de encaminhar headers manualmente) definem o que compõe a chave de cache: querystring, headers, cookies.
O padrão certo: bucket privado, CloudFront com OAC
Existem duas formas de o CloudFront acessar um bucket S3 de forma autenticada: Origin Access Identity (OAI), a mais antiga, e Origin Access Control (OAC). A documentação da AWS recomenda OAC pra origem nova, porque cobre casos que a OAI não cobre — todas as regiões de bucket, criptografia SSE-KMS no lado do servidor, e métodos dinâmicos como PUT/DELETE no S3.
O desenho recomendado combina duas coisas: o bucket nunca fica público, e o upload de conteúdo gerado por usuário não passa pelo CloudFront.
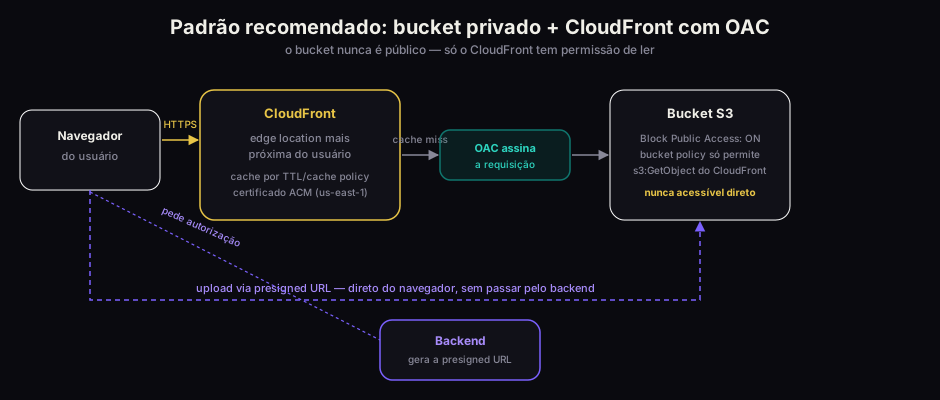
A bucket policy resultante é simples: só o principal cloudfront.amazonaws.com tem s3:GetObject, restrito por uma condição que amarra o acesso ao ARN da sua distribution específica — outra distribution, mesmo que sua, não tem esse acesso automaticamente.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AllowCloudFrontServicePrincipalReadOnly",
      "Effect": "Allow",
      "Principal": { "Service": "cloudfront.amazonaws.com" },
      "Action": "s3:GetObject",
      "Resource": "arn:aws:s3:::meu-bucket/*",
      "Condition": {
        "StringEquals": {
          "AWS:SourceArn": "arn:aws:cloudfront::111122223333:distribution/EDFDVBD6EXAMPLE"
        }
      }
    }
  ]
}
Domínio próprio e certificado
Pra usar um domínio seu (cdn.seusite.com) em vez do domínio gerado pela AWS, o CloudFront exige um certificado do ACM (AWS Certificate Manager). A regra que surpreende quem configura pela primeira vez: o certificado precisa ser solicitado na região us-east-1 (Norte da Virgínia), mesmo que seus outros recursos estejam noutra região — porque o CloudFront é um serviço global, e é dessa região específica que ele distribui o certificado pra todas as edge locations.
Conteúdo privado: signed URL e signed cookie
Quando o conteúdo não pode ser público (vídeo de curso pago, documento sensível), o CloudFront oferece signed URLs (uma URL por arquivo, com expiração) e signed cookies (autoriza acesso a vários arquivos de uma vez, útil pra um player que carrega segmento por segmento). Os dois usam um par de chaves configurado numa trusted key group da distribution; sem assinatura válida, o CloudFront responde 403 antes mesmo de perguntar ao bucket.
CloudFront Functions vs. Lambda@Edge
Os dois rodam código na borda, mas resolvem escalas diferentes de problema. Segundo a documentação da AWS: CloudFront Functions roda em toda requisição do visitante (viewer request/response) com altíssima performance e baixo custo, ideal pra manipulação leve — reescrever URL, adicionar cabeçalho de segurança, redirecionar. Lambda@Edge suporta os quatro eventos (viewer e origin, request e response), permite runtime completo do Node.js ou Python e tempo de execução maior, mas custa mais e só dispara em origin request/response quando associado a esse evento — ou seja, só roda em cache miss, não em toda requisição.
| CloudFront Functions | Lambda@Edge | |
|---|---|---|
| Eventos | Viewer request/response | Viewer e Origin, request/response |
| Runtime | JavaScript restrito | Node.js/Python completo |
| Quando roda (uso em origin) | Toda requisição do visitante | Só em cache miss (origin request/response) |
| Latência e custo | Muito baixo | Maior |
| Uso típico | Reescrita de URL, headers, roteamento por país | Personalização mais pesada, chamada a outro serviço |
A escolha prática: comece pela CloudFront Function. Suba pra Lambda@Edge só quando precisar de algo que ela não faz.
Cache: TTL, invalidação e o problema do deploy
TTL (time to live) é quanto tempo o CloudFront serve uma resposta cacheada antes de checar a origem de novo. Passado do deploy, dois caminhos resolvem “o usuário está vendo a versão antiga”:
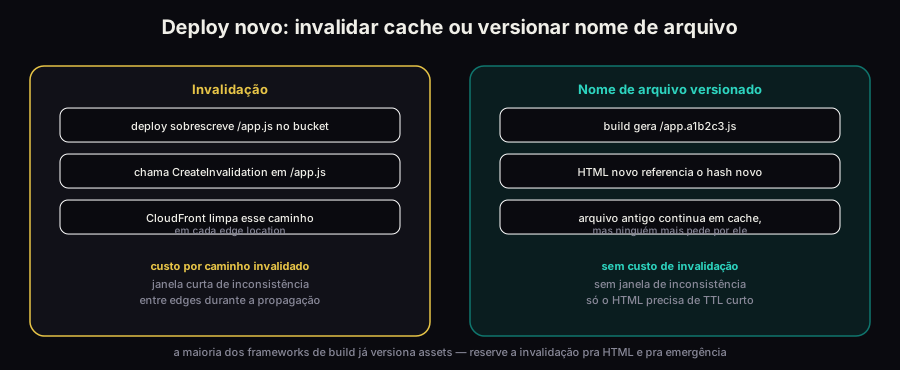
Invalidação. Você chama a API pedindo pra limpar um caminho (/app.js) ou um padrão (/*) em todas as edge locations. Funciona, mas tem custo por caminho invalidado além de uma cota gratuita mensal, e ainda existe uma janela curta em que edges diferentes podem responder versões diferentes até a invalidação se propagar.
Nome de arquivo versionado. A maioria dos bundlers já faz isso: cada build gera um nome com hash de conteúdo (app.a1b2c3.js), e o HTML novo aponta pro hash novo. O arquivo antigo continua em cache, mas ninguém mais pede por ele. Sem custo de invalidação, sem janela de inconsistência.
Na prática, o padrão mais comum combina os dois: assets com hash recebem TTL longo (dias ou semanas) e nunca precisam de invalidação; só o index.html (ou outro ponto de entrada que não muda de nome) leva TTL curto ou nenhum cache, e a invalidação fica reservada pra esse arquivo e pra emergência.
Custo: onde o dinheiro realmente vai
Três linhas concentram a maior parte da fatura:
- Armazenamento no S3. Preço por GB-mês, variando por classe — a tabela de classes lá em cima é literalmente uma tabela de custo.
- Requisições no S3.
GET,PUT,LISTsão cobrados por requisição, em faixas diferentes. - Transferência de dados de saída pra internet. Essa é a que mais surpreende: sair da AWS pra internet custa; a transferência de S3 pro CloudFront, dentro da rede da AWS, tem tarifa própria (diferente da saída direta do S3), e é o próprio CloudFront que entrega pro usuário final a partir dali.
Isso muda a leitura de “CloudFront é custo a mais”: pra um site com tráfego relevante, colocar CloudFront na frente do bucket tende a reduzir a fatura de transferência de saída, porque o tráfego repetido é resolvido no cache da borda em vez de sair do S3 a cada requisição — fora o ganho de latência, que não aparece na fatura mas aparece na experiência.
Os price classes do CloudFront deixam escolher em quais continentes suas edge locations operam: usar todas custa mais do que restringir a um subconjunto (por exemplo, só América do Norte e Europa). Se seu público está concentrado, vale restringir.
Exemplo: hospedando um SPA e aceitando upload de usuário
Reunindo as peças, um projeto comum — frontend estático mais avatar de usuário:
- Bucket do frontend, privado, recebendo o build via CI/CD. Bloqueio de acesso público ligado.
- CloudFront na frente, com OAC, domínio próprio e certificado ACM em
us-east-1. Cache behavior para/assets/*(arquivos com hash, TTL longo) e outro para/(oindex.html, TTL curto). - Bucket separado pro conteúdo do usuário (avatar, anexo), também privado. O backend gera presigned URL de
PUTrestrita ao key do usuário autenticado; o navegador sobe direto. - CORS configurado nesse segundo bucket, liberando
PUTa partir do domínio do frontend. - Se o avatar precisa ser servido publicamente depois, uma segunda distribution do CloudFront (ou um segundo cache behavior) aponta pra esse bucket, também via OAC — nunca pelo endpoint direto do S3.
Cada peça resolve um problema, e o bucket de conteúdo do usuário nunca fica acessível fora do fluxo que você desenhou.
Erros que custam caro depois
- Desligar Block Public Access sem necessidade real. Quase todo caso que parece precisar de bucket público na verdade precisa de CloudFront com OAC na frente de um bucket privado.
- Esquecer CORS e culpar o backend. Upload direto do navegador falhando por CORS parece erro de servidor até você olhar o console do navegador.
- Confundir durabilidade com disponibilidade. 11 noves de durabilidade não significa “nunca vai ficar fora do ar” — são garantias diferentes.
- Invalidar
/*a cada deploy por hábito. Funciona, mas custa mais do que precisa e esconde a falta de nome de arquivo versionado. - Certificado ACM na região errada. Pra CloudFront, se não foi pedido em
us-east-1, a distribution simplesmente não vai enxergar o certificado como opção. - Vazar
s3:*numa policy que só precisava de leitura. O escopo mínimo evita o incidente que você só descobre no dia em que alguém abusou dele.
O que fica
S3 resolve armazenar; CloudFront resolve entregar rápido e perto do usuário. Juntos, formam a espinha dorsal de qualquer frontend estático e de boa parte de conteúdo gerado por usuário na AWS — e o que separa uma configuração de tutorial de uma configuração de produção é justamente o que não aparece no “hello world”: bucket privado com OAC, presigned URL em vez de proxy pelo backend, certificado na região certa e uma estratégia de cache que não dependa de lembrar de invalidar toda hora.
Referências
- AWS. Amazon S3 User Guide — Storage Classes
- AWS. Amazon CloudFront Developer Guide — Restrict access to an Amazon S3 origin (OAC vs. OAI)
- AWS. Requirements for using SSL/TLS certificates with CloudFront
- AWS. Choosing between CloudFront Functions and Lambda@Edge
- No blog: AWS na prática: Lambda, S3, CloudFront e API Gateway