
Você tem um contêiner rodando num servidor com docker run. Funciona, até o dia em que o servidor reinicia no meio da noite e a aplicação fica fora do ar até alguém acordar. Ou até o tráfego crescer e você precisar de cinco cópias em três máquinas, com um endereço único na frente. Ou até a hora de publicar uma versão nova sem derrubar ninguém.
Fazer tudo isso à mão não escala. O Kubernetes (abreviado como K8s) é o sistema que assume esse trabalho: um software open source que automatiza o deploy, a escala e o gerenciamento de aplicações em contêineres, espalhadas por várias máquinas.
O que é o Kubernetes
Kubernetes é um orquestrador de contêineres. Um contêiner empacota uma aplicação com suas dependências, e o orquestrador decide em que máquina cada contêiner roda, quantas cópias existem, como elas se encontram e o que fazer quando uma falha.
A ideia central é o modelo declarativo. Você não diz “suba este contêiner naquela máquina”. Você descreve o estado desejado, algo como “quero três réplicas desta imagem, acessíveis na porta 80”, e o Kubernetes trabalha continuamente para fazer a realidade bater com essa descrição. Se um contêiner morre, o estado real deixa de coincidir com o desejado, e o cluster corrige.
Como o cluster funciona
O conjunto de máquinas gerenciado pelo Kubernetes se chama cluster, e pode ser feito de máquinas físicas ou virtuais. Ele tem duas partes.
O control plane é o cérebro. Ele agenda os contêineres nos nodes, mantém o estado desejado, escala as aplicações e coordena as atualizações. Os nodes são as máquinas de trabalho, onde as aplicações realmente rodam. Cada node tem um kubelet, o agente que gerencia aquela máquina e conversa com o control plane, além de um runtime de contêineres, como o containerd ou o CRI-O.
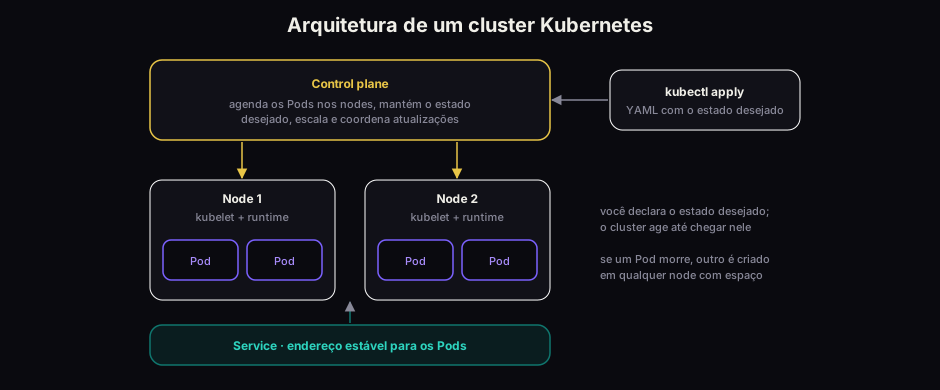
A comunicação passa toda pela API do Kubernetes, que o control plane expõe. Os componentes dos nodes falam com ela, e você também: a ferramenta de linha de comando kubectl é um cliente dessa API. Quando você aplica um arquivo YAML, está enviando o estado desejado a ela.
Pod, Deployment e Service
Três objetos cobrem a maior parte do uso inicial. Vale entender os três antes de qualquer outro.
O Pod é a menor unidade do Kubernetes: um ou mais contêineres que rodam juntos num node. Você raramente cria Pods diretamente, porque um Pod isolado não se recria sozinho quando morre.
O Deployment declara quantas réplicas de um Pod devem existir e como atualizá-las. É ele que faz o “mantenha três cópias rodando”. Se um Pod some, o Deployment cria outro.
O Service resolve um problema que o Deployment cria: Pods nascem e morrem, e cada um tem seu próprio endereço. O Service oferece um endereço estável e escolhe os Pods por label (um par chave-valor colado no objeto), distribuindo o tráfego entre eles.
Um exemplo mínimo. Primeiro o Deployment, com duas réplicas de nginx:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.27
          ports:
            - containerPort: 80
Repare na label app: web no template dos Pods e no selector do Deployment: é assim que ele reconhece quais Pods são seus. Fixe sempre a versão da imagem (nginx:1.27, não nginx:latest), para que o deploy de hoje seja reproduzível amanhã.
Agora o Service, que seleciona os Pods com essa mesma label:
apiVersion: v1
kind: Service
metadata:
  name: web
spec:
  selector:
    app: web
  ports:
    - protocol: TCP
      port: 80
      targetPort: 80
O port é a porta do Service, e targetPort é a porta do contêiner para onde o tráfego é encaminhado. Sem indicar um tipo, o Service é criado como ClusterIP, acessível apenas de dentro do cluster.
Aplicando e vendo o estado
Os dois manifestos podem ficar no mesmo arquivo, separados por ---. Aplique e confira:
kubectl apply -f web.yaml
kubectl get pods
kubectl get service web
O kubectl get pods deve listar duas réplicas. Para testar a autorrecuperação, apague um Pod com kubectl delete pod <nome> e liste de novo: o Deployment já criou um substituto. Para mudar a escala, edite replicas no YAML e aplique de novo, ou use kubectl scale deployment web --replicas=3.
Esse é o ciclo de trabalho no Kubernetes: editar o estado desejado, aplicar, deixar o cluster convergir. O YAML vai para o repositório, como qualquer outro código, e o histórico de mudanças da infraestrutura passa a ser o histórico do Git.
Outros objetos que você vai encontrar
A API do Kubernetes organiza os recursos em categorias. Os workloads (Pod, Deployment) rodam seus contêineres. Os recursos de descoberta e balanceamento (Service) ligam os workloads numa aplicação acessível. Os de configuração e armazenamento, como ConfigMap e Secret, injetam configurações e dados sensíveis nas aplicações e persistem dados fora do contêiner.
Há ainda recursos que alteram o comportamento de outros. O HorizontalPodAutoscaler, por exemplo, ajusta o número de réplicas conforme a carga, e é daí que vem a escala automática. Cada um desses merece um estudo próprio, mas todos seguem o mesmo molde: você declara, o cluster executa.
Como experimentar localmente
Você não precisa de um cluster de produção para aprender. O Minikube cria na sua máquina um cluster de um único node, disponível para Linux, macOS e Windows. Os comandos básicos são minikube start, stop, status e delete. Com ele rodando, o kubectl já aponta para esse cluster e os exemplos acima funcionam.
Quando vale a pena usar
O Kubernetes resolve o problema de operar muitos serviços em várias máquinas com alta disponibilidade. Em troca, cobra um custo real de aprendizado e de manutenção: redes, armazenamento, segurança e atualizações do próprio cluster passam a ser responsabilidade de alguém.
Faz sentido quando você tem vários serviços, precisa de escala e autorrecuperação, e tem (ou vai ter) gente para operar a plataforma, seja própria ou gerenciada por um provedor de nuvem. Para um app pequeno ou poucos serviços, a conta costuma fechar melhor com Docker Compose ou com uma plataforma gerenciada. Se esse é o seu caso, o post sobre Traefik com Docker Compose e múltiplos domínios mostra um caminho bem mais enxuto.
O que fica
O mais útil de entender sobre o Kubernetes não é a lista de objetos, e sim a mudança de postura: em vez de dar ordens a servidores, você escreve o resultado que quer e deixa um sistema reconciliar a realidade com o desejo, o tempo todo.
Para começar, suba um Minikube, aplique o Deployment e o Service deste post e apague um Pod só para ver o cluster se curar. Depois, antes de adotar Kubernetes num projeto real, responda com honestidade se o problema que você tem é de orquestração. Se for, você já conhece a base para ler o resto da documentação.
Referências
- Kubernetes. Documentação oficial, conceitos de Deployment, Pod e labels.
- Kubernetes. Service, documentação oficial.
- Kubernetes. Using Minikube to Create a Cluster, tutorial oficial de conceitos básicos.
- Kubernetes. Visão geral da API, categorias de recursos.