

Um alerta dispara às 3h da manhã: a API de pedidos está lenta. Você abre três abas e precisa responder três perguntas. Qual endpoint? Em qual serviço a chamada está travando? E o que mudou no último deploy?
Se a resposta exige adivinhar, conectar por SSH em servidor e dar grep em arquivo de log, o sistema tem monitoramento, mas não tem observabilidade. As ferramentas deste post existem para fechar essa diferença. O problema é que OpenTelemetry, Grafana, Sentry e Datadog aparecem sempre na mesma frase e parecem concorrentes. Não são. Cada uma atua numa parte diferente do caminho entre o código e a tela onde você investiga.
Monitoramento e observabilidade
Monitoramento responde a perguntas que você já sabia fazer: a CPU passou de 80%? A taxa de erro subiu? Você define de antemão o que olhar.
Observabilidade é a capacidade de entender o que está acontecendo por dentro do sistema a partir dos dados que ele emite, inclusive para perguntas que você não previu. “Por que só os usuários do plano X, só no fim do mês, veem lentidão?” não é um alerta que alguém configurou.
Esses dados emitidos se dividem em sinais. Os três clássicos:
- Logs: registros de eventos com timestamp. “Pedido 8123 falhou ao debitar o cartão.”
- Métricas: números agregados ao longo do tempo. Requisições por segundo, uso de memória, latência no percentil 95.
- Traces: o caminho de uma única requisição por vários serviços, dividido em spans (cada etapa com início e duração).
Um quarto tipo importa na prática: o erro com stack trace, isto é, a exceção capturada com o código exato onde quebrou. Ele pode ser derivado de logs, mas é tratado como cidadão de primeira classe por ferramentas como o Sentry.
O mapa: quem faz o quê
Antes de entrar em cada ferramenta, vale ver as camadas por onde o dado passa: instrumentar (gerar sinais no código), coletar (receber e encaminhar), armazenar (guardar e permitir consulta) e visualizar (dashboards, alertas, tela de investigação).
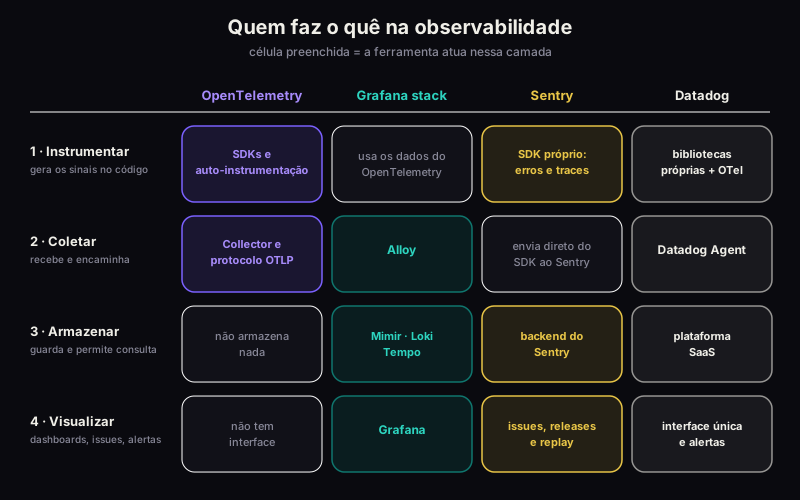
Duas leituras dessa matriz resolvem a maior parte da confusão:
- OpenTelemetry não substitui Grafana, Sentry nem Datadog. Ele fica no começo do caminho. Não armazena nada e não tem interface.
- Grafana stack, Sentry e Datadog são destinos. Cada um guarda dados e mostra uma tela, com filosofias diferentes.
OpenTelemetry: como produzir e transportar os dados
O que é. OpenTelemetry (OTel) é um projeto da CNCF que define um padrão aberto, independente de fornecedor, para gerar e transportar logs, métricas e traces. Ele nasceu da fusão de dois projetos anteriores, OpenTracing e OpenCensus.
Para que serve. Para instrumentar o código uma vez e escolher o destino depois. Sem ele, cada fornecedor tem seu próprio SDK, e trocar de ferramenta significa reinstrumentar a aplicação.
O OpenTelemetry tem quatro peças que valem conhecer:
| Peça | O que faz |
|---|---|
| API e SDK | bibliotecas por linguagem para criar spans, métricas e logs |
| Auto-instrumentação | captura HTTP, banco e frameworks conhecidos sem alterar seu código |
| OTLP | o protocolo padrão para enviar os dados (gRPC ou HTTP) |
| Collector | processo intermediário que recebe, processa e exporta a telemetria |
O que ele não faz. Não guarda dados e não desenha gráfico. Você sempre precisa de um backend.
Exemplo: instrumentando uma API Node.js
Um arquivo de instrumentação carregado antes da aplicação:
// instrumentation.ts
import { NodeSDK } from '@opentelemetry/sdk-node';
import { getNodeAutoInstrumentations } from '@opentelemetry/auto-instrumentations-node';
import { OTLPTraceExporter } from '@opentelemetry/exporter-trace-otlp-proto';

const sdk = new NodeSDK({
  traceExporter: new OTLPTraceExporter(),
  instrumentations: [getNodeAutoInstrumentations()],
});

sdk.start();
O nome do serviço e o destino vêm de variáveis de ambiente padronizadas, então o código não muda entre ambientes:
export OTEL_SERVICE_NAME=api-pedidos
export OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4318

node --import ./instrumentation.mjs app.js
Esse exemplo cobre traces. Métricas e logs seguem o mesmo padrão, com exportadores próprios.
Exemplo: o Collector no meio do caminho
O Collector é configurado em YAML, com receivers (entrada), processors (transformação) e exporters (saída), ligados por pipelines:
# otel-collector.yaml
receivers:
  otlp:
    protocols:
      grpc:
      http:

processors:
  batch:

exporters:
  debug:
  otlp/tempo:
    endpoint: tempo:4317
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [debug, otlp/tempo]
Aqui a aplicação envia OTLP ao Collector, que agrupa em lotes e encaminha os traces ao Tempo, além de imprimir no console para depuração. Para trocar o destino, você edita o YAML, sem tocar na aplicação.
Grafana stack: armazenar, consultar e visualizar
O que é. Um conjunto de ferramentas de código aberto da Grafana Labs. “Grafana stack” (ou LGTM) agrupa peças com papéis distintos:
| Componente | Papel |
|---|---|
| Grafana | interface: dashboards, exploração de dados e alertas |
| Loki | armazenamento e consulta de logs |
| Tempo | armazenamento de traces, com object storage como base |
| Mimir | armazenamento escalável e de longo prazo para métricas no formato Prometheus |
| Prometheus | coleta métricas por scrape e as consulta com PromQL |
| Alloy | distribuição do OpenTelemetry Collector com pipelines Prometheus |
LGTM vem das iniciais de Loki, Grafana, Tempo e Mimir.
Para que serve. Para ter um backend de observabilidade completo e sob seu controle: os dados ficam na sua infraestrutura (ou na Grafana Cloud, a versão gerenciada) e a Grafana consulta todos eles numa tela só. Correlacionar um pico de latência numa métrica com o trace e o log do mesmo momento vira um clique entre painéis.
Quando faz sentido. Quando você quer controle de custo e de onde os dados moram, e tem gente para operar a stack, o que inclui capacidade de armazenamento, retenção e upgrades. É um conjunto de peças que você compõe, não um produto único.
O que ele não faz bem. Ele não foi desenhado como rastreador de erros de aplicação. Uma exceção agrupada por causa, com stack trace, release e contexto do usuário, é o território do Sentry.
Sentry: o que quebrou no código
O que é. Uma plataforma de monitoramento de aplicações com foco em erros. O SDK captura exceções não tratadas com stack trace, agrupa ocorrências repetidas do mesmo problema numa única issue e associa cada erro à release que o introduziu.
Para que serve. Responder “o que quebrou, em que linha, para quem e desde qual deploy”. Além de erros, oferece monitoramento de performance com tracing distribuído e session replay, que reproduz o que o usuário fez na tela antes do erro.
O que ele guarda de contexto. Breadcrumbs (as ações que antecederam o erro), dados do usuário, tags, ambiente e versão. É isso que transforma “deu erro 500” em algo que dá para corrigir.
Exemplo: Sentry numa API Node.js
// sentry.ts (importar antes de todo o resto da aplicação)
import * as Sentry from '@sentry/node';

Sentry.init({
  dsn: process.env.SENTRY_DSN,
  environment: process.env.NODE_ENV,
  release: process.env.APP_VERSION,
});
E para registrar um erro tratado, com contexto:
try {
  await cobrarPedido(pedido);
} catch (erro) {
  Sentry.setTag('pedido_id', pedido.id);
  Sentry.captureException(erro);
  throw erro;
}
O release é o que permite ver, no Sentry, “este erro começou na versão 1.4.2”. Sem ele, você perde a resposta à terceira pergunta das 3h da manhã.
Se o OpenTelemetry já cuida dos traces, o SDK do Sentry tem integração com ele. A documentação orienta a não configurar o tracing do Sentry ao mesmo tempo, para os spans não ficarem duplicados. Consulte a documentação da versão que você usa.
Datadog: a plataforma que reúne tudo
O que é. Uma plataforma SaaS comercial que reúne, num produto só, monitoramento de infraestrutura, APM (traces), gerenciamento de logs, monitoramento de usuário real (RUM), testes sintéticos e segurança. Você instala o Datadog Agent nos hosts ou containers, e a coleta e o armazenamento ficam por conta da plataforma.
Para que serve. Para ter tudo integrado sem montar e operar peças. Métricas de servidor, traces de aplicação e logs aparecem correlacionados numa interface única, e os alertas ficam no mesmo lugar.
Quando faz sentido. Quando o time tem muitos serviços e pouca disposição para operar infraestrutura de observabilidade, e o custo de uma plataforma paga é aceitável. O ponto de atenção é justamente o custo: em geral ele cresce com o volume de dados enviados, então convém acompanhar o que se manda.
A conexão com o OpenTelemetry. O Datadog aceita OTLP. Você pode manter a instrumentação padrão do OTel e enviar os dados ao Agent com esta configuração:
# datadog.yaml
otlp_config:
  receiver:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
  logs:
    enabled: true

logs_enabled: true
Para os dados chegarem organizados por serviço, ambiente e versão, os atributos de recurso do OpenTelemetry cumprem o papel do que o Datadog chama de unified service tagging:
export OTEL_SERVICE_NAME=api-pedidos
export OTEL_RESOURCE_ATTRIBUTES="service.version=1.4.2,deployment.environment.name=prod"
Com isso, a mesma instrumentação que envia para o Tempo poderia enviar para o Datadog, mudando só o destino.
Como as peças se combinam
Na prática, ninguém usa uma ferramenta isolada. Um arranjo comum aparece abaixo: a aplicação emite dados via OpenTelemetry, o Collector encaminha ao backend escolhido, e o Sentry recebe os erros direto do SDK.
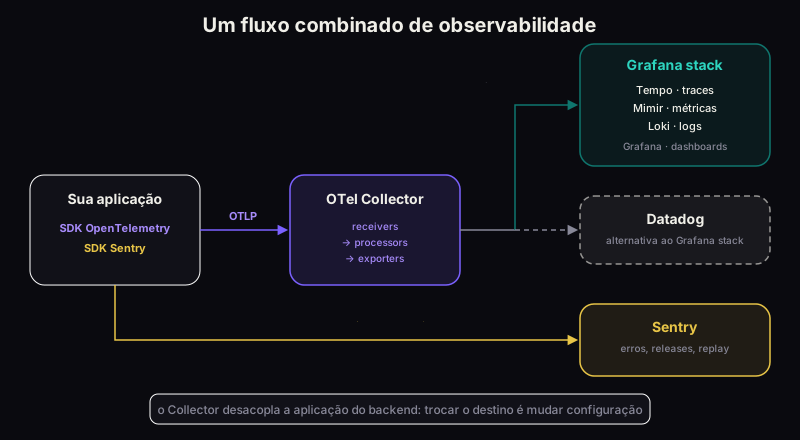
O Collector é o que dá flexibilidade a esse desenho. Como a aplicação só conhece o Collector, mudar de Grafana para Datadog, ou enviar para os dois durante uma migração, é mudança de configuração.
Qual pergunta cada ferramenta responde
Uma forma prática de escolher é partir das perguntas que você faz durante um incidente:
| Pergunta | Onde procurar |
|---|---|
| Por que esse endpoint está lento? | traces (Tempo, Datadog APM, tracing do Sentry) |
| O que quebrou depois do último deploy? | Sentry, por release |
| O servidor está sem memória ou CPU? | métricas (Mimir/Prometheus, Datadog infra) |
| O que aconteceu naquela requisição específica? | logs (Loki, Datadog Logs) correlacionados por trace ID |
| O que o usuário fez antes do erro? | session replay do Sentry |
| A taxa de erro está subindo agora? | métricas com alerta (Grafana, Datadog) |
Por que isso importa no ecossistema
Correlação. O ganho real não está em ter três sinais, mas em ligá-los. O padrão W3C Trace Context propaga um identificador de trace entre serviços pelo cabeçalho traceparent. Quando o log, o span e o erro carregam o mesmo ID, você parte de um erro no Sentry e chega ao trace completo e aos logs da mesma requisição.
Menos tempo até entender. O tempo entre o alerta e a causa raiz costuma ser gasto procurando onde olhar. Com sinais correlacionados e uma tela por camada, essa busca encurta.
Portabilidade. Instrumentar com OpenTelemetry mantém o código independente do fornecedor. Trocar o backend deixa de ser projeto de reescrita.
Cultura de responsabilidade. Quem escreve o serviço passa a enxergar como ele se comporta em produção. Isso muda decisões de design, como o que logar, onde colocar timeouts e o que vale medir.
Como escolher por onde começar
Sugestões de combinação, dependendo do contexto:
| Contexto | Combinação para considerar |
|---|---|
| Time pequeno, produto web, pouco tempo | Sentry para erros, mais os logs do seu provedor |
| Quer controle dos dados e do custo, tem quem opere infra | OpenTelemetry + Grafana stack, com Sentry para erros |
| Muitos serviços, pouca capacidade de operar infra | Datadog, instrumentado com OpenTelemetry para manter portabilidade |
Nenhuma é a resposta certa em geral. O que vale em qualquer uma é começar pequeno: um serviço instrumentado, um destino, um alerta que exige ação.
Erros comuns
- Instrumentar tudo, sem amostragem. Enviar 100% dos traces de um serviço com muito tráfego eleva custo e ruído. Defina amostragem e revise.
- Métricas com alta cardinalidade. Usar
user_idourequest_idcomo label multiplica o número de séries e pode derrubar o backend de métricas. IDs únicos ficam em traces e logs. - Ferramentas sem ID em comum. Se o log não carrega o trace ID, a correlação não acontece, e você tem três silos.
- Nomes inconsistentes.
service.namediferente para o mesmo serviço em ambientes distintos quebra dashboards e alertas. - Alerta sem ação. Alerta que ninguém sabe o que fazer com ele vira fadiga, e o alerta importante passa despercebido.
- Dado sensível nos sinais. Senhas, tokens e dados pessoais em logs, breadcrumbs ou atributos de span. Filtre antes de enviar.
O que fica
Observabilidade não é uma ferramenta, é uma cadeia: gerar os sinais, transportá-los, guardá-los e enxergá-los. OpenTelemetry é o padrão que cuida do começo da cadeia. Grafana stack, Sentry e Datadog cuidam do fim, cada uma com sua ênfase: controle e composição, erros de código, ou plataforma integrada.
A pergunta útil para o seu time não é qual das quatro escolher, e sim onde a cadeia está quebrada hoje. Se um serviço degrada às 3h da manhã, você sabe em qual tela olhar primeiro? Se a resposta é “depende”, o próximo passo é instrumentar um serviço e ligar os sinais pelo mesmo trace ID.
Referências
- OpenTelemetry, documentação oficial: https://opentelemetry.io/docs
- OpenTelemetry Collector, configuração: https://opentelemetry.io/docs/collector
- OpenTelemetry para JavaScript, exportadores e Node.js: https://opentelemetry.io/docs/languages/js
- Grafana Labs, documentação de Grafana, Loki, Tempo, Mimir e Alloy: https://grafana.com/docs
- Sentry, documentação dos SDKs (JavaScript e Node.js): https://docs.sentry.io
- Datadog, ingestão OTLP pelo Agent e unified service tagging: https://docs.datadoghq.com/opentelemetry
- W3C, Trace Context: https://www.w3.org/TR/trace-context