
“SQL ou NoSQL” é a pergunta errada. A certa é: seus dados têm relacionamento forte e você precisa de transação multi-tabela, ou seu acesso é por chave e o volume de escrita vai crescer mais rápido do que um servidor aguenta sozinho? A resposta muda o banco.
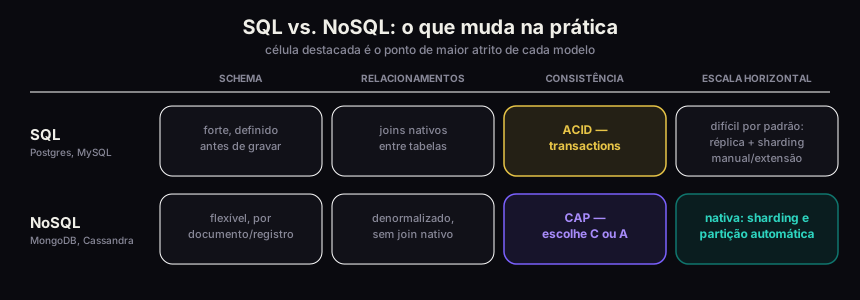
SQL: schema forte, relacionamento, transação
Banco relacional organiza dado em tabelas com schema definido antes de gravar. Cada coluna tem tipo, cada tabela pode ter chave estrangeira apontando pra outra, e o SGBD garante essa integridade — não deixa você inserir um pedido com cliente_id que não existe.
Isso dá duas coisas que NoSQL não tem de graça: join (juntar tabelas numa query só) e ACID:
- Atomicidade — a transação inteira aplica ou nenhuma parte aplica.
- Consistência — toda regra e constraint do schema continua válida depois da transação.
- Isolamento — transações concorrentes não enxergam estado parcial umas das outras.
- Durabilidade — depois do commit, o dado sobrevive a uma queda do servidor.
Transferência bancária é o exemplo clássico: debitar de uma conta e creditar em outra precisa ser atômico. Se o crédito falhar depois do débito, sem ACID, dinheiro desaparece.
Exemplos de SGBD relacional: PostgreSQL, MySQL/MariaDB, Microsoft SQL Server, Oracle Database, SQLite (embarcado).
NoSQL: schema flexível, escala em primeiro lugar
NoSQL não é uma tecnologia — é uma categoria de bancos que abriu mão de schema rígido e de join nativo em troca de estrutura mais flexível e escala mais simples. Dentro dela cabem modelos bem diferentes:
- Documento — registros como JSON aninhado. Ex.: MongoDB, Couchbase.
- Chave-valor — leitura e escrita por chave, o mais rápido e o mais simples. Ex.: Redis, DynamoDB.
- Coluna larga — otimizado para escrita massiva e séries temporais. Ex.: Cassandra, HBase.
- Grafo — nós e arestas como estrutura de primeira classe, pra consulta de relacionamento profundo. Ex.: Neo4j.
O ponto em comum não é “sem SQL” — é que cada um desses modelos decidiu abrir mão de alguma garantia do relacional pra ganhar outra coisa. No caso do documento e do chave-valor, o que se ganha, na maioria das implementações, é escalabilidade horizontal nativa.
O Teorema CAP
Assim que o banco deixa de rodar num nó só e passa a ser um cluster distribuído, entra em jogo o Teorema CAP, formulado por Eric Brewer: um sistema distribuído só entrega duas das três garantias ao mesmo tempo — Consistência (todo nó vê o mesmo dado), Disponibilidade (toda requisição recebe resposta) e Tolerância a Partição (o sistema continua funcionando mesmo se a rede entre nós falhar).
Na prática, partição de rede vai acontecer — cabo rompido, link entre datacenters instável, timeout. Então P não é opção, é dado. A escolha real é entre C e A quando a partição ocorre.
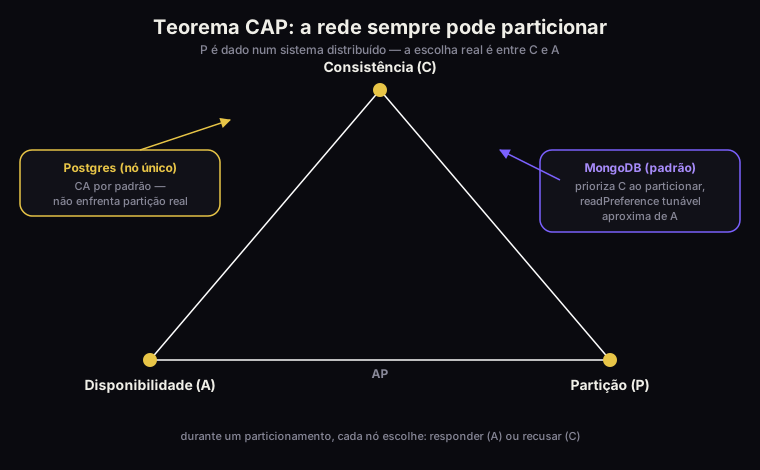
- Postgres num servidor só não faz parte dessa escolha — não há partição a enfrentar. Quando você monta um cluster Postgres, a decisão de CP ou AP se transfere pra sua topologia de replicação.
- MongoDB, por padrão, prioriza consistência: durante uma partição, um shard sem maioria de votos no seu replica set para de aceitar escrita em vez de servir dado potencialmente desatualizado. É configurável — o
readPreferencee owriteConcerndão a você a opção de ler de uma réplica secundária e ganhar disponibilidade em troca de possível defasagem.
Como avaliar: SQL ou NoSQL
Quatro perguntas, nesta ordem:
1. Você precisa de transação multi-entidade? Se “criar pedido” precisa debitar estoque, gravar pagamento e criar entrega como uma unidade atômica, isso é nativo em SQL e trabalhoso de simular em NoSQL. MongoDB tem transações multi-documento desde a versão 4.0, mas o modelo pede desenho cuidadoso — não é o padrão que você usa sem pensar, é a exceção que você ativa quando precisa.
2. Seu dado é mais relacionamento ou mais documento? Catálogo de produto com atributo variável por categoria, perfil de usuário com estrutura que muda, log de evento — isso é forma de documento, cabe bem em JSON aninhado. Pedido, cliente, fatura, estoque com relação clara entre entidades — isso é forma relacional.
3. Qual seu padrão de leitura? Query ad-hoc, relatório, filtro cruzando várias tabelas — SQL com índice bem pensado ganha. Leitura por chave primária, sempre no mesmo formato, alto volume — chave-valor ou documento ganham, porque não pagam custo de join.
4. Você já sabe que vai precisar de escrita distribuída por várias regiões ou volume que um servidor não aguenta? Se sim, isso pesa a favor de um NoSQL com sharding nativo. Se sua carga cabe confortavelmente num servidor bem dimensionado com réplicas de leitura, adicionar a complexidade operacional de um cluster distribuído antes de precisar é custo sem benefício.
Não é raro terminar com os dois. Catálogo em MongoDB, pedido e pagamento em Postgres, cache de sessão em Redis — cada modelo de dado no banco que resolve o problema dele.
Escalabilidade horizontal na prática
Escalar vertical é trocar o servidor por um maior — mais CPU, mais RAM, disco mais rápido. Simples, mas tem teto físico e custo que cresce mais rápido que linear. Escalar horizontal é distribuir a carga entre vários servidores. É o que sustenta volume que nenhuma máquina única aguenta, mas troca simplicidade operacional por complexidade de coordenação.
PostgreSQL: réplica é fácil, escrita distribuída pede ajuda
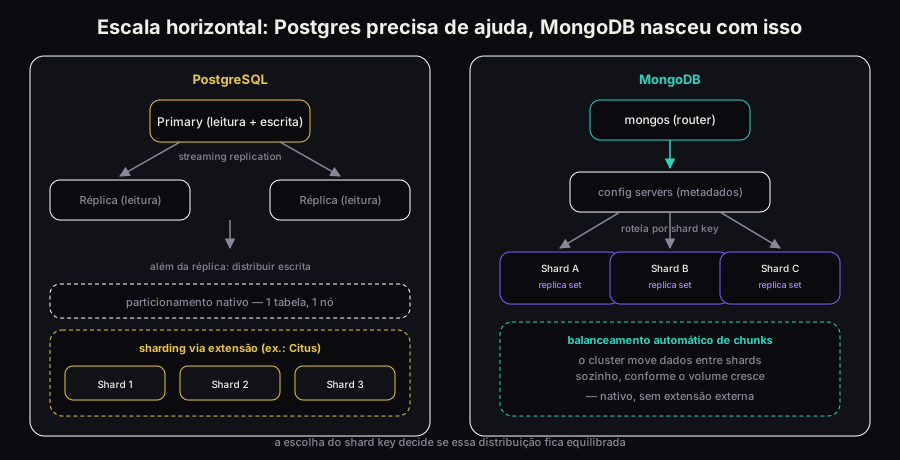
Postgres nasceu pensado pra um nó. A escala horizontal vem em camadas, cada uma cobrindo um problema diferente:
- Streaming replication. O primary manda o WAL (write-ahead log) pras réplicas quase em tempo real. Resolve escala de leitura: você aponta relatório e dashboard pras réplicas e deixa o primary livre pra escrita. Não resolve escala de escrita — ainda existe um único primary.
- Particionamento declarativo (
PARTITION BY RANGE/LIST/HASH, nativo desde o Postgres 10). Divide uma tabela grande em partições menores por critério — data, região, hash de ID. Query com filtro na chave de partição só varre a partição certa, mas tudo ainda roda num nó só. Resolve performance de tabela grande, não resolve limite de um servidor. - Sharding entre nós. Pra distribuir dado e escrita entre várias máquinas, Postgres puro não faz sozinho — precisa de extensão. Citus (código aberto, mantido pela Microsoft) transforma um cluster Postgres num sistema distribuído: distribui tabela por uma
distribution column, paraleliza query entre os nós (workers) e mantém a interface SQL e as extensões do Postgres normais. Também existem bancos compatíveis com o protocolo Postgres nascidos distribuídos, como CockroachDB e YugabyteDB, pra quem quer sharding nativo sem depender de extensão.
A ordem importa: a maioria dos projetos resolve o gargalo real só com réplica de leitura e particionamento. Sharding entre nós é passo de quem já esgotou os anteriores.
MongoDB: sharding é arquitetura de origem
MongoDB foi desenhado com cluster distribuído como caso de uso central, não como extensão posterior. As peças:
- Shard key. Campo (ou combinação de campos) que decide em qual shard cada documento vive. É a decisão mais importante do desenho: shard key mal escolhida concentra dado e escrita num shard só e anula o ganho de ter cluster.
- Shards. Cada shard é, ele mesmo, um replica set — um primary e réplicas, com failover automático se o primary cair.
- Config servers. Guardam os metadados do cluster: qual faixa de shard key está em qual shard.
- mongos. O roteador que a aplicação enxerga como se fosse um MongoDB único. Ele consulta os config servers e manda cada query só pro(s) shard(s) relevante(s).
- Balanceamento automático. Conforme os dados crescem, o cluster migra
chunks(faixas de shard key) entre shards sozinho, sem intervenção manual, pra manter a distribuição equilibrada.
A troca é operacional: você ganha escrita distribuída nativa, mas precisa operar config servers, monitorar o balanceador e principalmente escolher bem a shard key — trocar shard key de uma coleção já grande é uma migração cara, não um ALTER.
O que fica
SQL e NoSQL não competem pelo mesmo trabalho. Um garante relacionamento e transação num modelo mais rígido; o outro troca rigidez por flexibilidade e, na maioria dos casos, por escala horizontal mais simples de operar desde o primeiro dia.
Postgres escala lendo fácil e escrevendo com esforço crescente — réplica primeiro, partição depois, sharding via extensão só se o volume realmente pedir. MongoDB nasce pensando em cluster, e cobra isso na forma de mais peça pra operar e uma decisão de shard key que não perdoa erro tardio.
A pergunta que resolve a escolha não é “qual é mais moderno” — é qual conjunto de garantias o seu domínio não pode abrir mão, e qual complexidade operacional seu time aguenta pagar agora, versus quando o volume realmente exigir.
Referências
- Eric Brewer. CAP Twelve Years Later: How the “Rules” Have Changed — o autor do teorema revisitando as implicações práticas.
- PostgreSQL. Documentação oficial — High Availability, Load Balancing, and Replication e Table Partitioning.
- Citus Data. Documentação do Citus — extensão de sharding para PostgreSQL.
- MongoDB. Documentação oficial — Sharding e Read Concern / Write Concern.