
Imagine que o serviço de pagamentos, em vez de responder em 200 ms, passa a levar 8 segundos. Ele não caiu: só ficou lento. Em poucos minutos, as requisições do seu checkout se acumulam esperando por ele, as conexões do pool acabam e a tela inteira trava, inclusive as partes que nem usam pagamento.
Falhas assim são normais em sistemas que dependem de rede, de terceiros e de outros times. Padrões defensivos são as técnicas que impedem que um problema local vire uma queda geral: eles assumem que tudo o que está fora do seu controle vai, em algum momento, falhar, atrasar ou vir errado.
Este post reúne os padrões que mais pagam o custo de implementar: validação na borda, timeout, retry com backoff e jitter, idempotência, circuit breaker, bulkhead e degradação graciosa. Os exemplos estão em TypeScript, mas as ideias valem para qualquer linguagem.
Programação defensiva e design para falha
O termo cobre duas camadas que convém separar. A primeira é a programação defensiva em sentido estrito: dentro do código, você desconfia de entradas e verifica pré-condições antes de agir. A segunda é o design para falha: na arquitetura, você assume que dependências vão falhar e limita o estrago.
As duas se completam. Validar entradas não ajuda quando o banco fica lento, e um circuit breaker não ajuda quando o dado inválido já entrou no domínio. O resto do post vai do mais interno ao mais externo.
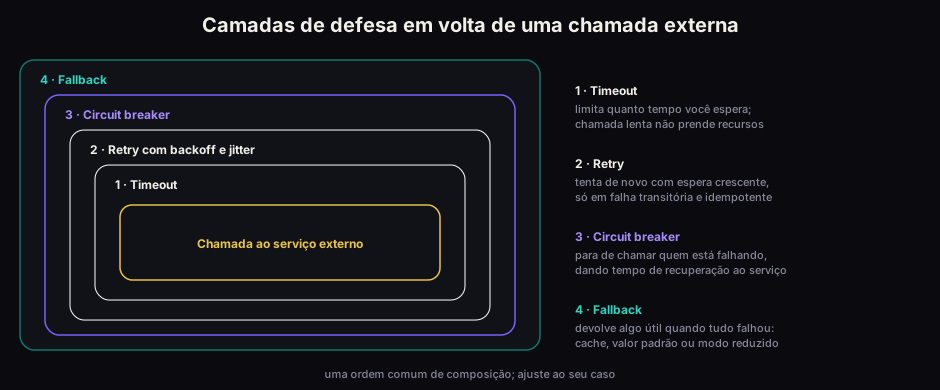
O diagrama mostra como as proteções de rede se empilham em volta de uma chamada. Cada camada resolve um problema que a de dentro não resolve, e é por isso que usar só uma delas costuma ser insuficiente.
Validar na borda e falhar rápido
A regra mais barata: todo dado que cruza uma fronteira (requisição HTTP, mensagem de fila, arquivo, variável de ambiente) é tratado como não confiável até ser verificado. Depois de verificado, ele entra no sistema já com o tipo certo, e o código interno não precisa duvidar dele de novo.
Essa ideia é conhecida como “parse, don’t validate” (analise, não apenas valide): em vez de checar e continuar usando o dado cru, você converte a entrada numa estrutura que só existe se for válida.
type Item = { sku: string; qtd: number };
type Pedido = { itens: Item[] };

class ErroDeValidacao extends Error {}

function parsePedido(entrada: unknown): Pedido {
  if (typeof entrada !== 'object' || entrada === null) {
    throw new ErroDeValidacao('corpo da requisição inválido');
  }
  const { itens } = entrada as Record<string, unknown>;
  if (!Array.isArray(itens) || itens.length === 0) {
    throw new ErroDeValidacao('o pedido precisa ter ao menos um item');
  }
  return {
    itens: itens.map((item) => {
      const { sku, qtd } = item as Record<string, unknown>;
      if (typeof sku !== 'string' || sku === '') {
        throw new ErroDeValidacao('sku inválido');
      }
      if (!Number.isInteger(qtd) || (qtd as number) < 1 || (qtd as number) > 100) {
        throw new ErroDeValidacao('quantidade deve ser um inteiro entre 1 e 100');
      }
      return { sku, qtd: qtd as number };
    }),
  };
}
Em projetos reais, uma biblioteca de schemas como Zod faz esse trabalho com menos código. O princípio não muda: depois de parsePedido, o resto do sistema recebe um Pedido e pode confiar nele.
O complemento é falhar rápido (fail fast): se uma pré-condição não vale, pare agora, com um erro claro, em vez de seguir com dado estranho e quebrar três funções depois. Um throw na primeira linha da função é mais barato de depurar do que um undefined que atravessa o sistema.
Timeout em toda chamada externa
Uma chamada sem timeout espera para sempre se o outro lado não responder. Foi isso que travou o checkout do início do post. A regra é simples: nenhuma chamada de rede sem limite de tempo.
const resposta = await fetch('https://api.exemplo.com/pagamentos', {
  signal: AbortSignal.timeout(3000), // aborta após 3 segundos
});
O valor certo vem da realidade, não de um número redondo: olhe a latência medida da dependência e escolha um limite um pouco acima do que ela leva em condições boas. Timeout longo demais não protege; curto demais gera falsos erros.
O mesmo vale para o banco de dados (timeout de consulta) e para o pool de conexões (timeout para obter uma conexão). Um timeout isolado já evita a classe de problema mais comum, a espera infinita.
Retry com backoff exponencial e jitter
Algumas falhas passam sozinhas: um erro 503 momentâneo, uma conexão que caiu. Tentar de novo resolve esses casos, desde que seja feito com cuidado. O retry ingênuo, que repete imediatamente, pode transformar um serviço lento em um serviço derrubado, porque todos os clientes insistem ao mesmo tempo.
Backoff exponencial aumenta a espera a cada tentativa. Jitter é um componente aleatório que espalha as tentativas no tempo, para que os clientes não voltem sincronizados:
const dormir = (ms: number) => new Promise((r) => setTimeout(r, ms));

async function comRetry<T>(
  fn: () => Promise<T>,
  { tentativas = 4, baseMs = 200, tetoMs = 5000 } = {},
): Promise<T> {
  for (let i = 0; ; i++) {
    try {
      return await fn();
    } catch (erro) {
      const ultima = i + 1 >= tentativas;
      if (ultima || !ehTransitorio(erro)) throw erro;
      const teto = Math.min(tetoMs, baseMs * 2 ** i);
      await dormir(Math.random() * teto); // jitter: espera aleatória até o teto
    }
  }
}
A função ehTransitorio decide o que vale repetir: timeouts, erro 429 (limite de requisições) e 503 sim; erro 400 ou 404 não, porque repetir não muda o resultado. Também limite o total de tentativas, ou o retry vira um laço infinito disfarçado.
Idempotência: repetir sem duplicar
Retry cria um risco: se a primeira chamada chegou ao servidor mas a resposta se perdeu, a segunda cobra o cliente duas vezes. Uma operação é idempotente quando executá-la várias vezes produz o mesmo efeito que executá-la uma.
Para operações que não são naturalmente idempotentes, como criar um pagamento, o padrão é a chave de idempotência: o cliente gera um identificador único por intenção e o envia junto (costuma ir num cabeçalho Idempotency-Key). O servidor guarda o resultado associado à chave:
async function criarPagamento(chave: string, dados: Pagamento) {
  const anterior = await armazem.obter(chave);
  if (anterior) return anterior; // já processado: devolve o mesmo resultado

  const resultado = await gateway.cobrar(dados);
  await armazem.salvar(chave, resultado);
  return resultado;
}
Esse esboço tem uma brecha: duas requisições simultâneas com a mesma chave passam juntas pelo obter antes de qualquer salvar. Na prática, a reserva da chave precisa ser atômica, por exemplo com um índice único no banco, de forma que só uma das requisições avance.
Circuit breaker
O retry ajuda quando a falha é passageira. Quando a dependência está realmente fora, continuar tentando só piora a situação, para ela e para você. O circuit breaker (disjuntor) observa as falhas e, passado um limite, para de chamar por um tempo.
Ele tem três estados. Fechado: as chamadas passam normalmente. Aberto: as chamadas falham imediatamente, sem tocar na dependência. Semiaberto: depois de uma espera, deixa passar uma chamada de teste; se der certo, fecha de novo.
class CircuitBreaker {
  private falhas = 0;
  private abertoAte = 0;

  constructor(private limite = 5, private esperaMs = 10_000) {}

  async executar<T>(fn: () => Promise<T>): Promise<T> {
    if (Date.now() < this.abertoAte) {
      throw new Error('circuito aberto: dependência indisponível');
    }
    try {
      const resultado = await fn();
      this.falhas = 0;
      return resultado;
    } catch (erro) {
      if (++this.falhas >= this.limite) {
        this.abertoAte = Date.now() + this.esperaMs;
      }
      throw erro;
    }
  }
}
Esta versão é didática: passado o esperaMs, a próxima chamada funciona como teste, e se falhar o circuito reabre. Em produção, prefira uma biblioteca madura, porque os detalhes (concorrência no estado semiaberto, janelas de contagem, métricas) são fáceis de errar.
Bulkhead: isolar para não afundar junto
O nome vem das divisórias estanques de um navio: se um compartimento alaga, os outros continuam secos. Em software, bulkhead é separar os recursos de cada dependência ou funcionalidade para que o consumo excessivo de uma não esgote os da outra.
O caso típico é o pool de conexões ou de threads. Se relatórios pesados e pagamentos dividem o mesmo pool, uma onda de relatórios deixa o pagamento sem conexão. Com pools separados, o relatório pode travar sozinho e o pagamento segue funcionando.
Degradação graciosa e kill switch
Quando uma parte falha, a pergunta útil é: o que o usuário ainda pode fazer? Degradação graciosa é entregar uma versão reduzida da funcionalidade em vez de um erro. É o fallback do diagrama:
async function recomendacoes(usuarioId: string) {
  try {
    return await breaker.executar(() => api.recomendar(usuarioId));
  } catch (erro) {
    logger.warn({ erro, usuarioId }, 'recomendações indisponíveis, usando mais vendidos');
    return maisVendidos(); // pior que o personalizado, melhor que a tela quebrada
  }
}
Repare no logger.warn. Um catch que engole o erro em silêncio esconde o problema: o fallback funciona, ninguém percebe que a dependência caiu, e a falha só aparece quando já é grande.
Um kill switch complementa o fallback: uma configuração (uma feature flag, por exemplo) que desliga uma funcionalidade inteira sem novo deploy. Quando uma feature nova se comporta mal em produção, desligá-la em segundos vale mais do que reverter uma versão.
Quando a defesa vira o problema
Defesa em excesso tem custo, e alguns erros aparecem com frequência.
Retry sem limite e sem jitter amplifica uma falha: se cada uma de mil requisições tenta quatro vezes, a dependência que já estava lenta recebe quatro vezes mais carga. Verificações de null espalhadas por todo o código interno escondem invariantes que deveriam ser garantidas na borda, e fazem o código parecer mais seguro do que está. E um catch genérico que devolve um valor padrão transforma um bug em dado errado, que é mais difícil de achar do que um erro.
A regra prática: seja desconfiado nas fronteiras e explícito no interior. Dentro do domínio, prefira falhar rápido com erro claro a continuar com dado suspeito.
Defesa que você nunca exercitou é palpite. Teste o comportamento sob lentidão e erro, por exemplo com testes de carga com k6, e torne visível quando o circuit breaker abre ou o fallback entra, com métricas e alertas como os descritos em observabilidade com OpenTelemetry, Grafana, Sentry e Datadog.
O que fica
Cada padrão deste post responde a uma pergunta que você pode fazer sobre qualquer chamada externa do seu sistema: quanto tempo eu espero? Posso repetir sem duplicar? Se estiver falhando, eu continuo insistindo? E se tudo falhar, o que o usuário vê?
Não é preciso implementar tudo de uma vez. Comece pelo que tem melhor custo-benefício: timeout em toda chamada de rede e validação na borda. Depois adicione retry com jitter onde a operação for idempotente, e circuit breaker onde a dependência for crítica. O resultado é um sistema em que uma falha em um ponto deixa de se espalhar por todos os outros.
Referências
- Michael T. Nygard. Release It! Design and Deploy Production-Ready Software, 2ª edição. Pragmatic Bookshelf, 2018. Fonte dos padrões de estabilidade como timeout, circuit breaker, bulkhead e fail fast.
- Marc Brooker. Timeouts, retries and backoff with jitter, Amazon Builders’ Library.
- Alexis King. Parse, don’t validate, 2019.
- Microsoft, Azure Architecture Center. Circuit Breaker pattern.
- Stripe. Idempotent requests, documentação da API.