
Quando um cliente finaliza um pedido, o checkout precisa enviar um e-mail, baixar o estoque, avisar o faturamento e alimentar um painel de vendas. Se o código do pedido chamar tudo isso em sequência, qualquer serviço lento ou fora do ar trava a compra inteira.
A saída é mensageria: o checkout publica um aviso de “pedido criado” e segue em frente, e cada interessado processa esse aviso no seu tempo. RabbitMQ e Kafka são as duas ferramentas mais citadas para isso, e a confusão entre elas é comum porque as duas “movem mensagens”. Elas fazem isso de formas bem diferentes.
O que é RabbitMQ
RabbitMQ é um message broker: um servidor intermediário que recebe mensagens de quem publica (o produtor) e as entrega a quem consome (o consumidor). Ele suporta vários protocolos, entre eles o AMQP, e ficou conhecido pelo modelo de roteamento.
O produtor não envia direto para uma fila. Ele publica numa exchange, e bindings (regras ligadas à exchange) decidem quais filas recebem uma cópia da mensagem. A exchange começa vazia, uma tabela de roteamento sem regras, e só passa a entregar para alguma fila quando alguém cria um binding.
O tipo de exchange define o algoritmo de roteamento. Existem, entre outros, o tipo direct (chave exata), topic (padrões com curinga, como orders.eu.*.priority), fanout (copia para todas as filas) e headers (decide por cabeçalhos). Como o roteamento vive no broker, os clientes podem mudá-lo em tempo de execução, sem redeploy.
Atrás da exchange ficam as filas, e o tipo de fila muda o comportamento. Nas filas quorum e classic, a leitura é destrutiva: depois que o consumidor confirma o processamento (o ack), a mensagem sai da fila. Existe ainda o tipo stream, um log de acréscimo em que a leitura não apaga nada e dá para reprocessar.
O que é Kafka
Apache Kafka é uma plataforma de streaming de eventos. Em vez de filas que se esvaziam, ele guarda eventos num log: uma sequência ordenada em que novos eventos são sempre acrescentados ao final.
Os eventos ficam organizados em tópicos, que a documentação compara a uma pasta num sistema de arquivos, com os eventos fazendo o papel dos arquivos. Um tópico aceita qualquer número de produtores e de consumidores. E, ao contrário de um sistema de filas tradicional, o evento não é apagado depois de lido: ele fica pelo tempo definido na configuração do tópico (retention.ms), independentemente de alguém já tê-lo consumido.
Para escalar, cada tópico é dividido em partições, espalhadas por vários brokers. Eventos com a mesma chave (o id de um cliente, por exemplo) caem sempre na mesma partição, e o Kafka garante que quem lê uma partição vê os eventos na mesma ordem em que foram escritos.
Quem lê se organiza em consumer groups. Cada grupo é um assinante lógico formado por vários processos, e guarda o próprio offset: a posição até onde já leu em cada partição. Qualquer número de grupos pode ler o mesmo tópico de forma independente, sem duplicar dados, e um grupo novo pode começar do início do histórico.
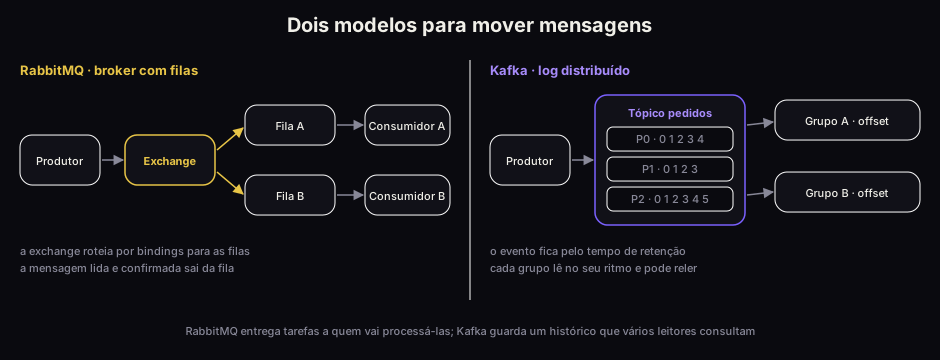
O diagrama resume a diferença de fundo. No RabbitMQ, a mensagem é uma tarefa que anda até uma fila e some depois de processada. No Kafka, o evento é um registro que permanece no log, e cada leitor só avança o seu ponteiro.
Diferenças em uma tabela
| Aspecto | RabbitMQ | Kafka |
|---|---|---|
| Modelo | Broker com exchanges, bindings e filas | Log distribuído em tópicos e partições |
| Leitura | Normalmente destrutiva (a mensagem sai da fila após o ack) | Não destrutiva (o evento fica pela retenção) |
| Reprocessar histórico | Só com streams | Natural: relê a partir de um offset |
| Roteamento | Flexível, no broker (direct, topic, fanout, headers) | Simples: tópico e chave de partição |
| Ordem | Por fila | Garantida dentro de cada partição |
| Vários leitores do mesmo dado | Uma fila por interessado, via bindings | Um consumer group por interessado, sobre o mesmo tópico |
| Escala | Distribuição de trabalho entre consumidores | Partições espalhadas por brokers, lidas em paralelo |
O mesmo pedido nos dois
Voltando ao checkout. No RabbitMQ, você cria uma exchange do tipo topic e uma fila para cada interessado, ligada por um binding à chave pedido.criado:
rabbitmqadmin --vhost "loja" bindings declare \
  --source "eventos" --destination-type "queue" \
  --destination "fila.email" --routing-key "pedido.criado"
Repita para fila.estoque e fila.faturamento. O checkout publica uma vez na exchange eventos, e cada fila recebe sua cópia. Se o serviço de e-mail cair, as mensagens esperam na fila.email sem afetar os outros.
No Kafka, você cria um tópico pedidos e escolhe o id do pedido como chave:
kafka-topics.sh --create --topic pedidos --partitions 3 \
  --bootstrap-server localhost:9092
O checkout escreve o evento uma vez. O faturamento lê com o grupo faturamento, o painel com o grupo analytics, e cada um avança no seu ritmo. Se o time de dados criar um grupo novo daqui a um mês, ele pode reler todos os pedidos que ainda estão dentro da retenção.
Quando usar cada um
RabbitMQ costuma ser a escolha natural quando a mensagem é uma tarefa que alguém precisa executar: enviar um e-mail, gerar um PDF, processar um upload. O que importa é distribuir o trabalho entre consumidores, rotear com regras (por tipo, região, prioridade) e descartar a mensagem quando ela foi cumprida. A documentação do próprio RabbitMQ aponta as filas quorum para distribuição de trabalho em que segurança dos dados e alta disponibilidade importam.
Kafka costuma ser a escolha natural quando a mensagem é um evento: algo que aconteceu e que vários sistemas podem querer ler, agora ou depois. Pipelines de dados, analytics em tempo real, integração entre muitos serviços e qualquer caso em que reprocessar o passado tem valor.
Os dois também se sobrepõem. O RabbitMQ tem streams para quem precisa de replay, e o Kafka pode servir de fila de trabalho com consumer groups. Nesses casos, a pergunta de desempate é qual dos dois seu time já sabe operar, porque cada broker é um sistema distribuído para manter.
Cuidados que valem para os dois
Em qualquer sistema de mensageria, falhas podem fazer o mesmo consumidor receber a mesma mensagem mais de uma vez. Por isso o processamento precisa ser idempotente: repetir não pode duplicar o efeito, como cobrar o cliente duas vezes. Detalhei isso, junto com retry e circuit breaker, em padrões defensivos de engenharia de software.
Outro ponto: a ordem só vale dentro do escopo em que é garantida, uma fila no RabbitMQ e uma partição no Kafka. Se a ordem entre eventos de um mesmo cliente importa, a chave de partição precisa ser o id desse cliente. E mensageria troca simplicidade por operação: broker, monitoramento e filas acumuladas passam a ser parte do seu sistema.
O que fica
A pergunta que separa os dois não é “qual é melhor”, e sim “o que é a mensagem”. Se ela é uma tarefa a ser cumprida e descartada, pense em fila e em roteamento: RabbitMQ. Se é um fato que deve ficar registrado e poder ser relido por quem chegar depois, pense em log: Kafka.
Antes de adotar qualquer um, confirme que você precisa mesmo de um broker. Para um único consumidor e baixo volume, uma fila no próprio banco de dados costuma bastar. Quando o desacoplamento entre serviços virar o problema real, você já sabe a pergunta que decide a ferramenta.
Referências
- RabbitMQ. RabbitMQ and Kafka: comparison, documentação oficial.
- RabbitMQ. Exchanges and bindings, documentação oficial.
- Apache Kafka. Introduction: main concepts and terminology, documentação oficial.
- Apache Kafka. Documentação de implementação (offsets e group coordinator) e configuração de tópicos (
retention.ms), no repositório github.com/apache/kafka.